근거 중심 에디터 Agent
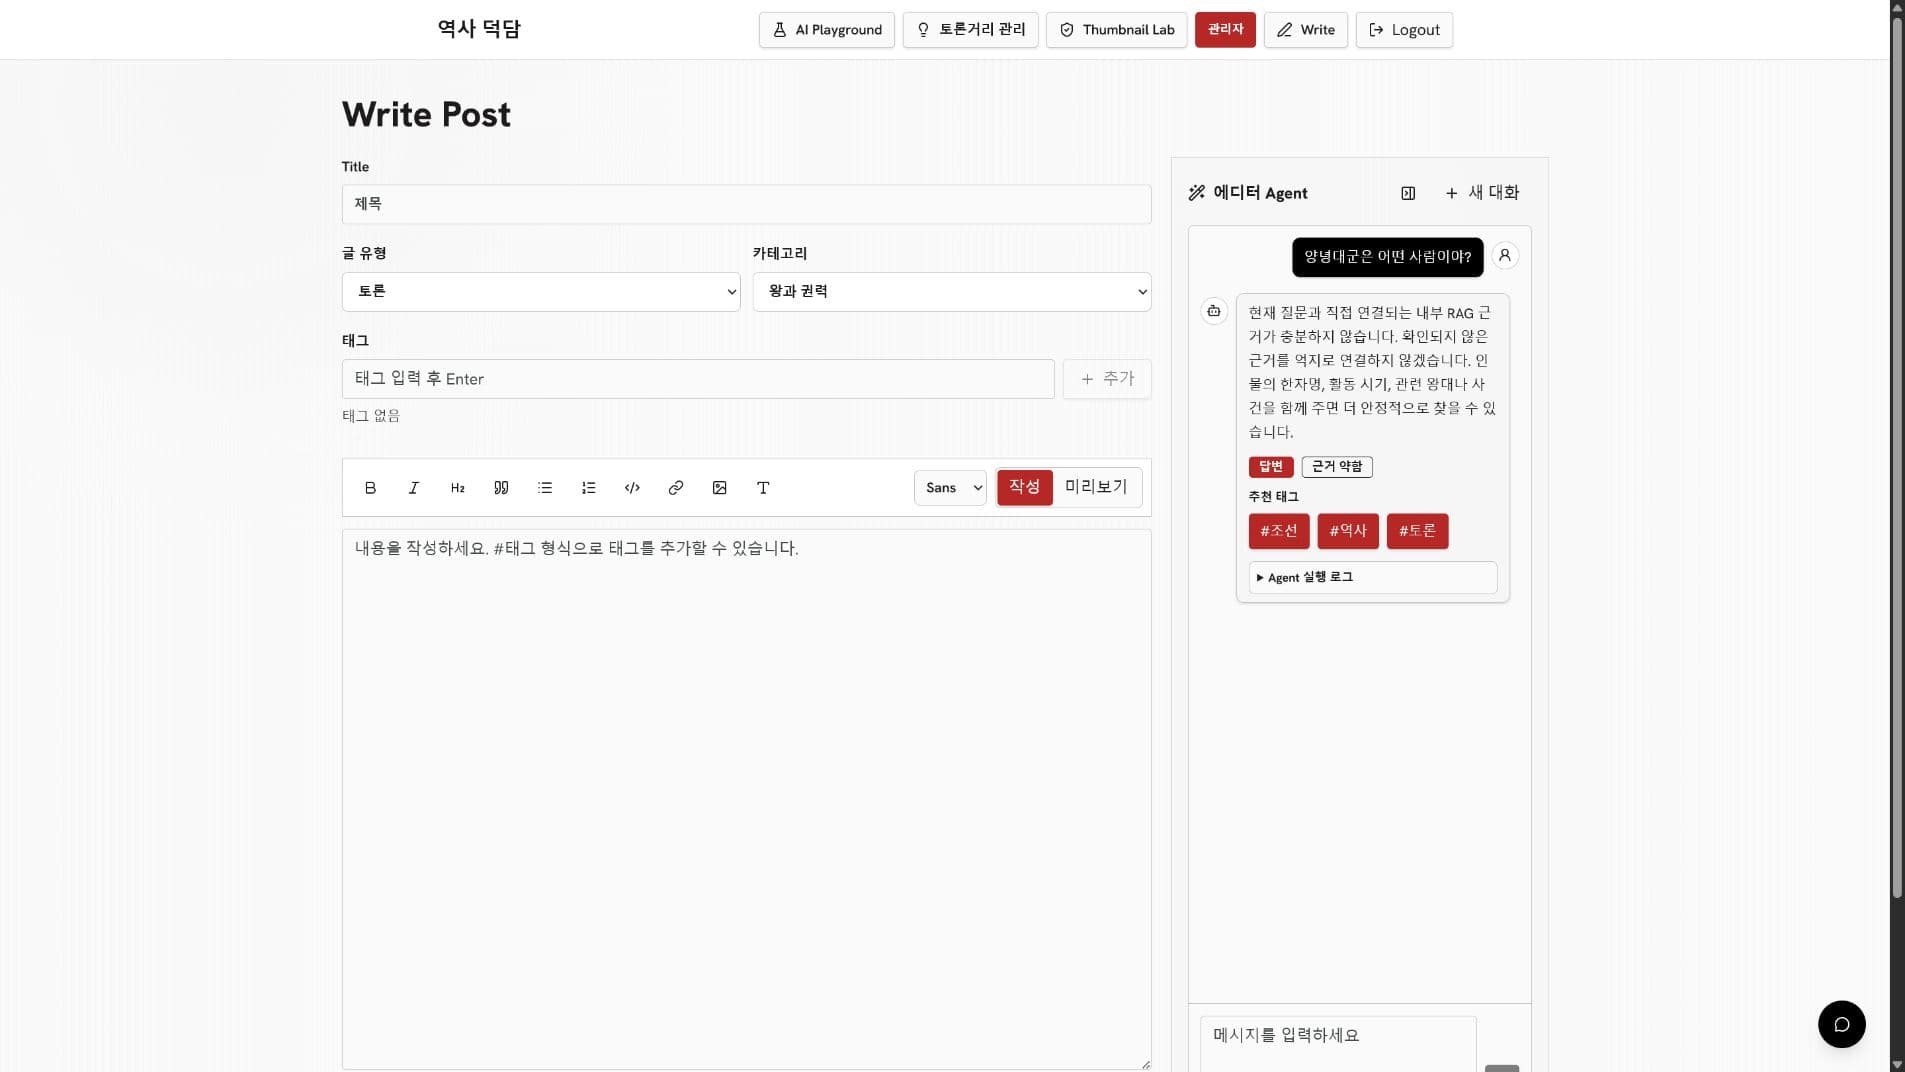
게시글 작성 화면 안에서 질문 답변, 새 본문 작성, 기존 본문 수정을 요청할 수 있습니다. Agent가 현재 글의 맥락과 대화 기록을 함께 보고 제목·본문·태그·토론 질문을 제안하며, 사용자는 필요한 결과만 에디터에 적용합니다.
 PROJECT / HISTORY-DEOKDAM
조선시대 인물과 사건을 주제로 글을 쓰고 토론하면서, AI가 답변에 사용한 역사 자료까지 함께 확인할 수 있는 웹 커뮤니티입니다.
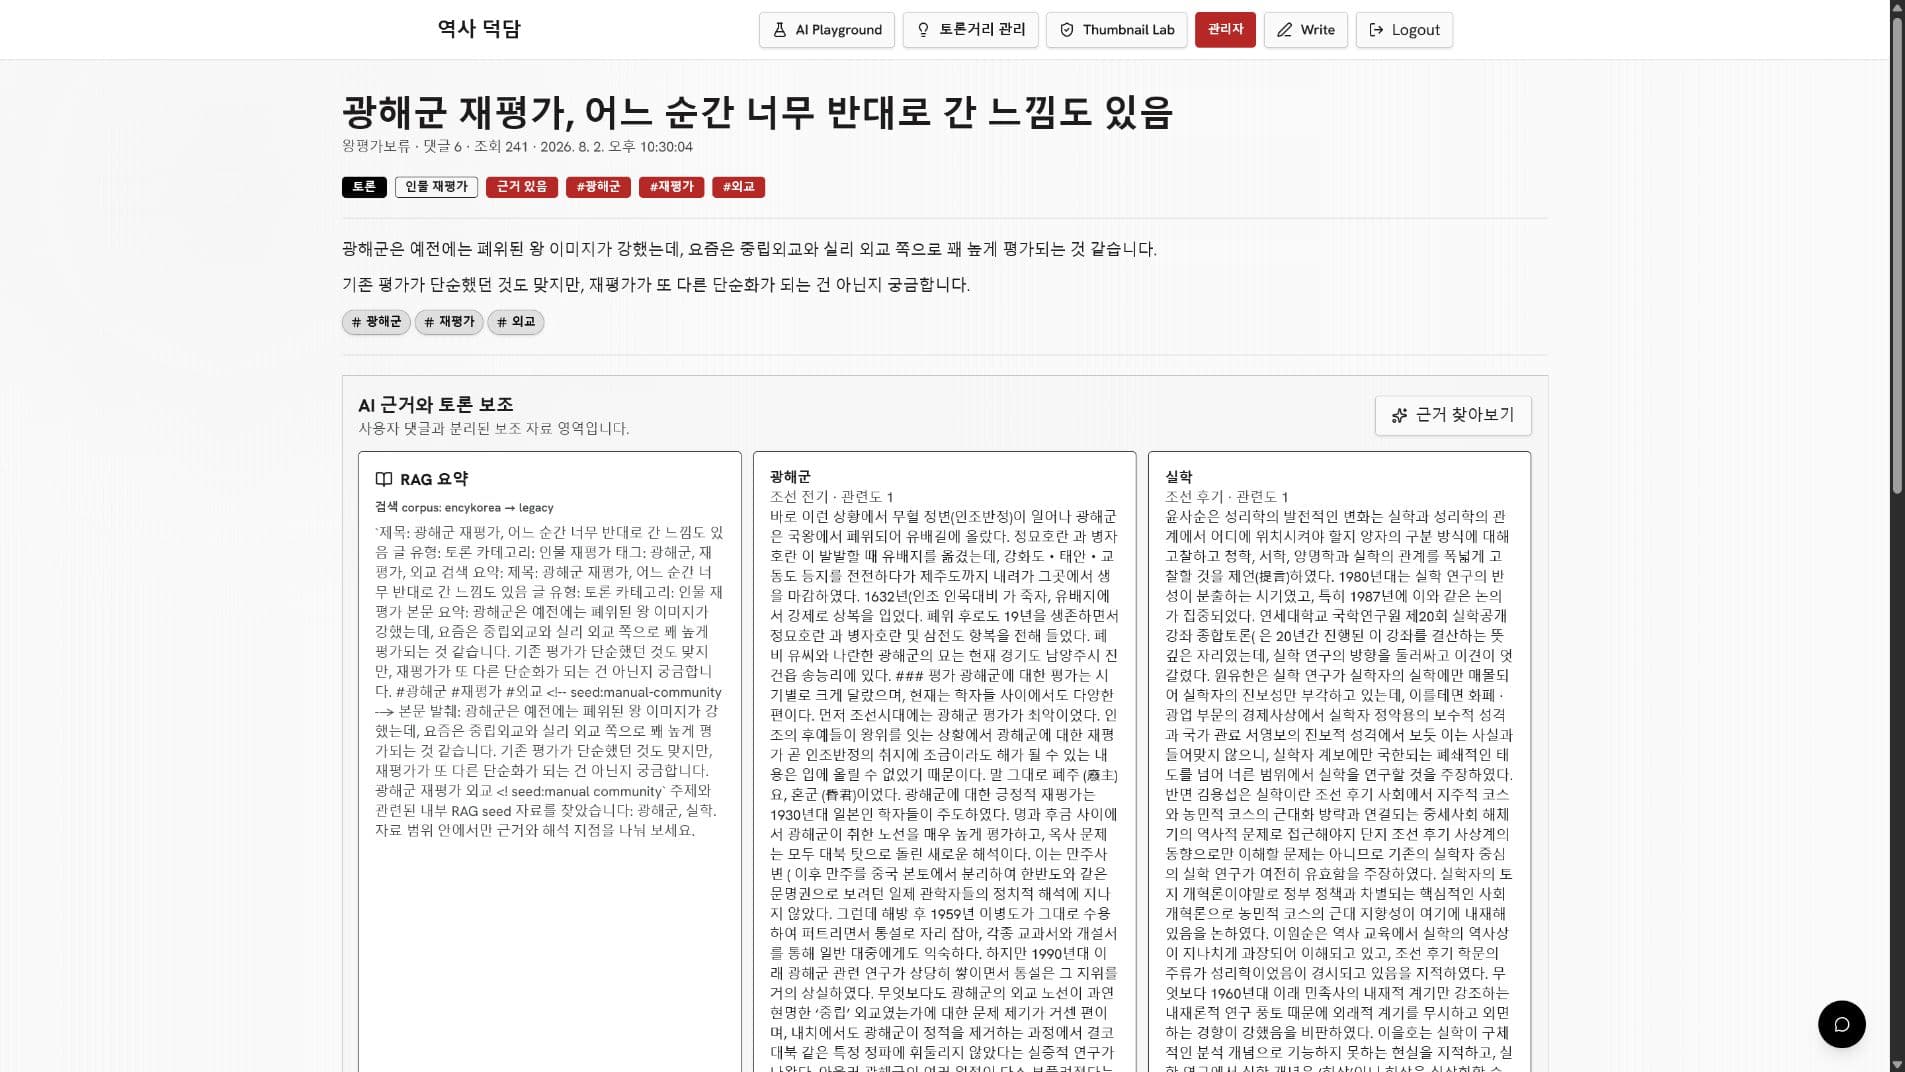
사용자의 제목·본문·질문을 이해한 Agent가 내부 역사 자료를 검색하고 외부 자료로 근거를 보강합니다. 근거가 충분할 때만 글과 태그, 토론 질문을 제안하고, 확인되지 않은 내용은 `weak_evidence`로 표시해 자연스러운 문장 때문에 잘못된 역사 정보가 사실처럼 보이는 문제를 줄였습니다.
사용자가 실제로 경험하는 핵심 기능입니다.
게시글 작성 화면 안에서 질문 답변, 새 본문 작성, 기존 본문 수정을 요청할 수 있습니다. Agent가 현재 글의 맥락과 대화 기록을 함께 보고 제목·본문·태그·토론 질문을 제안하며, 사용자는 필요한 결과만 에디터에 적용합니다.
조선왕조실록과 역사 개요 자료를 의미 검색하고, 내부 근거가 부족하면 네이버 검색과 실록 검색을 연결해 외부 후보를 찾습니다. 인물과 사건이 실제로 일치하는지 판정한 뒤 관련 없는 자료를 제외합니다.
회원가입과 로그인, 게시글·댓글 작성 및 수정·삭제, 카테고리·태그·검색·페이지네이션을 제공합니다. Markdown 작성과 미리보기를 지원하고 작성자 권한을 서버에서 확인합니다.
로그인 사용자를 위한 전역 역사 챗봇, 최근 글과 사료를 조합한 오늘의 토론거리, 글의 내용을 반영한 썸네일 후보 생성, 관리자용 AI Playground를 구현했습니다.
기능을 만들기 위해 직접 설계하고 구현한 기술 영역입니다.
사용자 요청을 `intent → retrieve → external_search → respond` 단계로 나눴습니다. 질문 답변·본문 생성·본문 수정 의도를 분류하고 내부 RAG, 외부 자료, 근거 부족 상태를 하나의 구조화된 응답으로 반환합니다.
수집한 사료를 Markdown으로 정규화하고 문서와 청크를 데이터베이스에 동기화한 뒤 임베딩을 생성했습니다. 저장소 기준 3,709건의 자료를 실록 원문, 역사 개요, 실록 v2 검증 자료로 나누고 질문 성격에 따라 검색 우선순위를 달리했습니다.
JSON-RPC 2.0 기반 MCP 서버에 실록 검색, 네이버 검색, 웹 검색, 썸네일 생성 도구를 등록했습니다. Agent가 도구를 호출하면 사용한 검색어와 결과 상태, 근거 후보를 함께 기록하도록 구성했습니다.
외부 검색과 게시글 목록에 Redis 캐시를 적용했습니다. 임베딩 결과가 없거나 API 키를 사용할 수 없을 때는 키워드 검색으로 전환해 핵심 커뮤니티 기능과 검색 흐름이 모두 멈추지 않도록 했습니다.
Next.js 클라이언트가 FastAPI 서버와 통신하고, 서버의 Agent가 내부 RAG와 MCP 외부 도구를 조합합니다. 서비스 데이터와 임베딩은 PostgreSQL에, 반복 조회 결과는 Redis에 저장합니다.
장녹수를 질문했는데 세종이나 양녕대군 자료처럼 검색 점수만 높은 다른 인물의 문서가 근거로 채택될 수 있었습니다.
기존 판정은 유사도 임계값만 확인해 질문의 핵심 인물·사건이 문서 제목과 요약에 실제로 포함됐는지 검사하지 않았습니다.
질문에서 핵심 개체를 추출하고 citation의 제목·시대·요약과 대조했습니다. 내부 근거와 외부 자료를 주요 근거와 대중문화 보조 자료로 다시 분류하고, 직접 연결되지 않는 결과는 제외했습니다.
관련 없는 내부 요약이 본문에 섞이지 않게 되었고, 내부 자료가 부족할 때는 외부 자료 후보라는 한계를 명확히 표시하게 됐습니다.
`어우동이 누구야` 같은 질문에 화면 전체 문맥이 검색어로 전달되어 결과가 없었고, 외부 검색과 실록 검증을 모두 기다리면서 응답이 길어졌습니다.
Agent에 외부 검색 도구가 연결돼 있어도 검색어 정제와 도구 호출 순서가 정의되지 않았고, 모든 질문이 느린 실록 검증 경로를 거쳤습니다.
질문어와 조사를 제거해 핵심 검색어를 만들고 네이버에서 후보를 찾은 뒤 필요한 경우에만 실록으로 검증했습니다. 인물명이 상위 결과에서 확인되면 빠르게 반환하고, 공급자별 제한 시간과 Redis 캐시를 적용했습니다.
8개 평가 질문 모두 상위 3개 결과에서 기대 핵심어를 찾았습니다. 짧은 인물 질문은 새 요청 기준 84~163ms, 같은 질문의 캐시 재요청은 대부분 2~26ms로 줄었습니다.
홈 화면의 같은 목록을 반복해서 요청할 때마다 데이터베이스 조회와 정렬이 실행됐습니다.
페이지, 검색어, 카테고리, 정렬 조건별 결과를 재사용하는 계층이 없었습니다.
조건을 포함한 Redis 캐시 키와 10초 TTL을 적용하고, 글 작성·수정·삭제와 썸네일 변경 때 관련 캐시를 무효화했습니다.
게시글 50개 환경에서 200회 순차 요청의 평균 응답 시간이 6.28ms에서 3.61ms로 42.5% 감소했고 처리량은 156.97 req/s에서 274.31 req/s로 74.8% 증가했습니다.