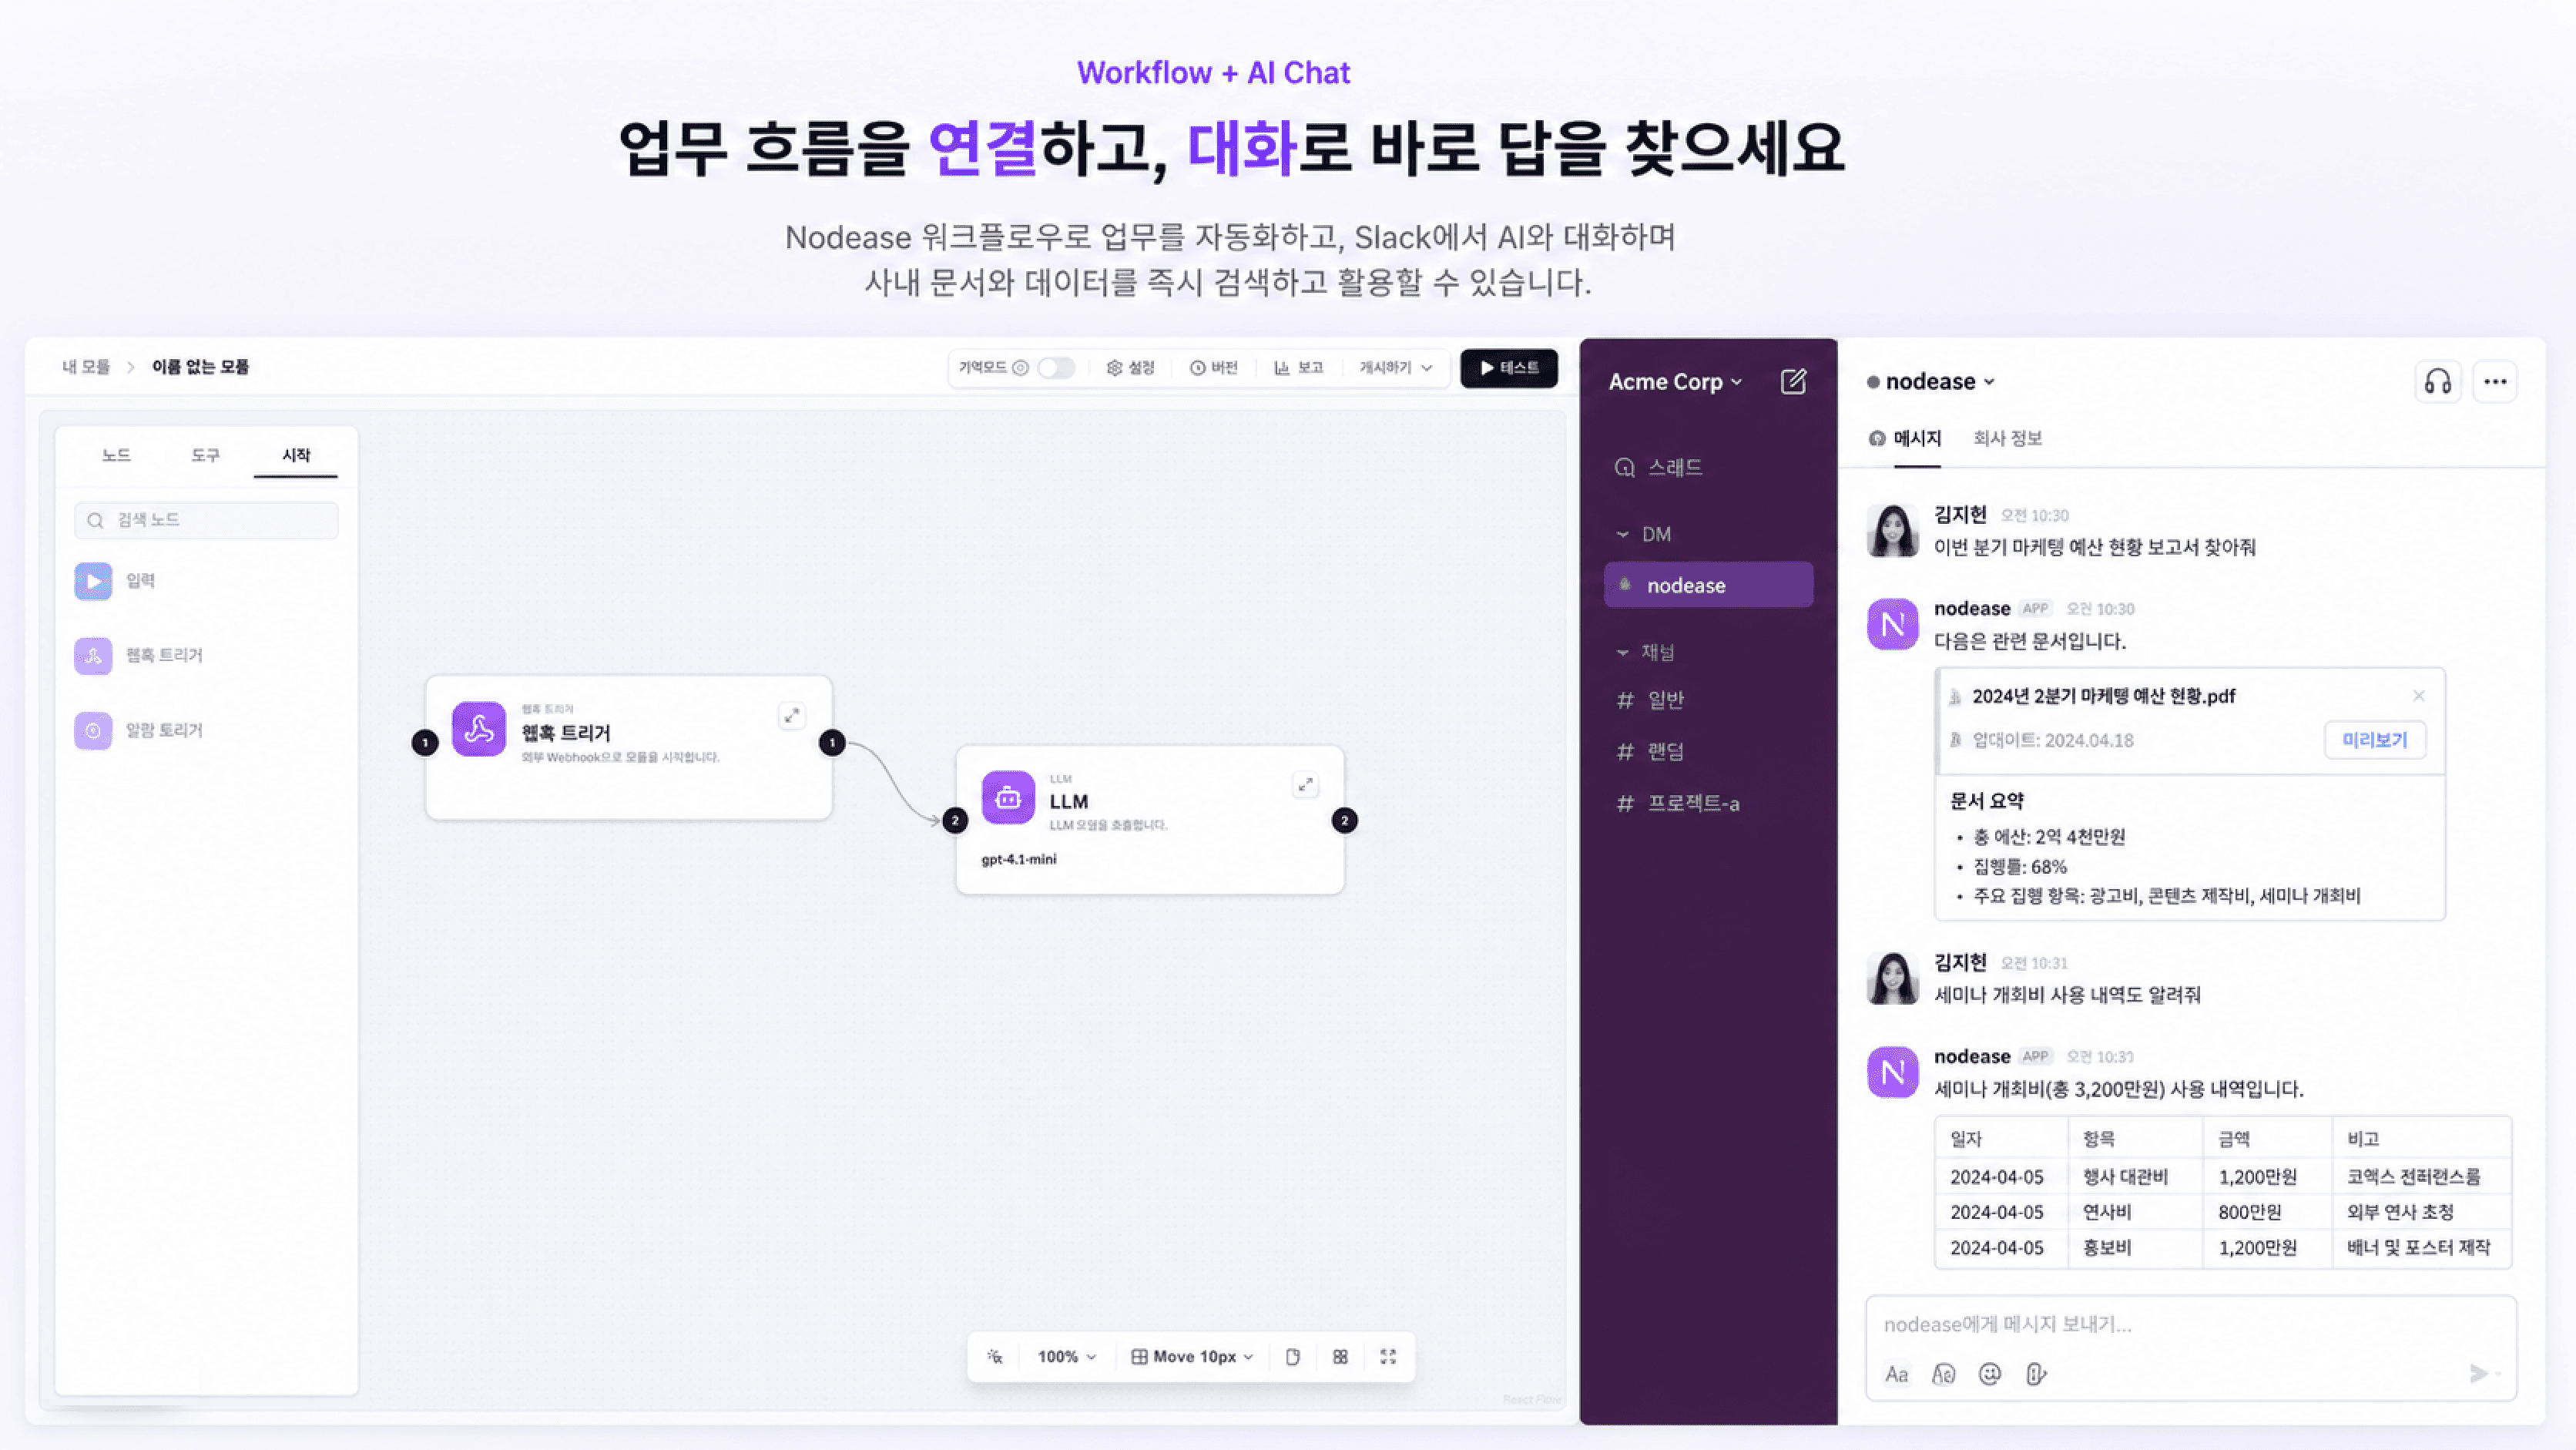
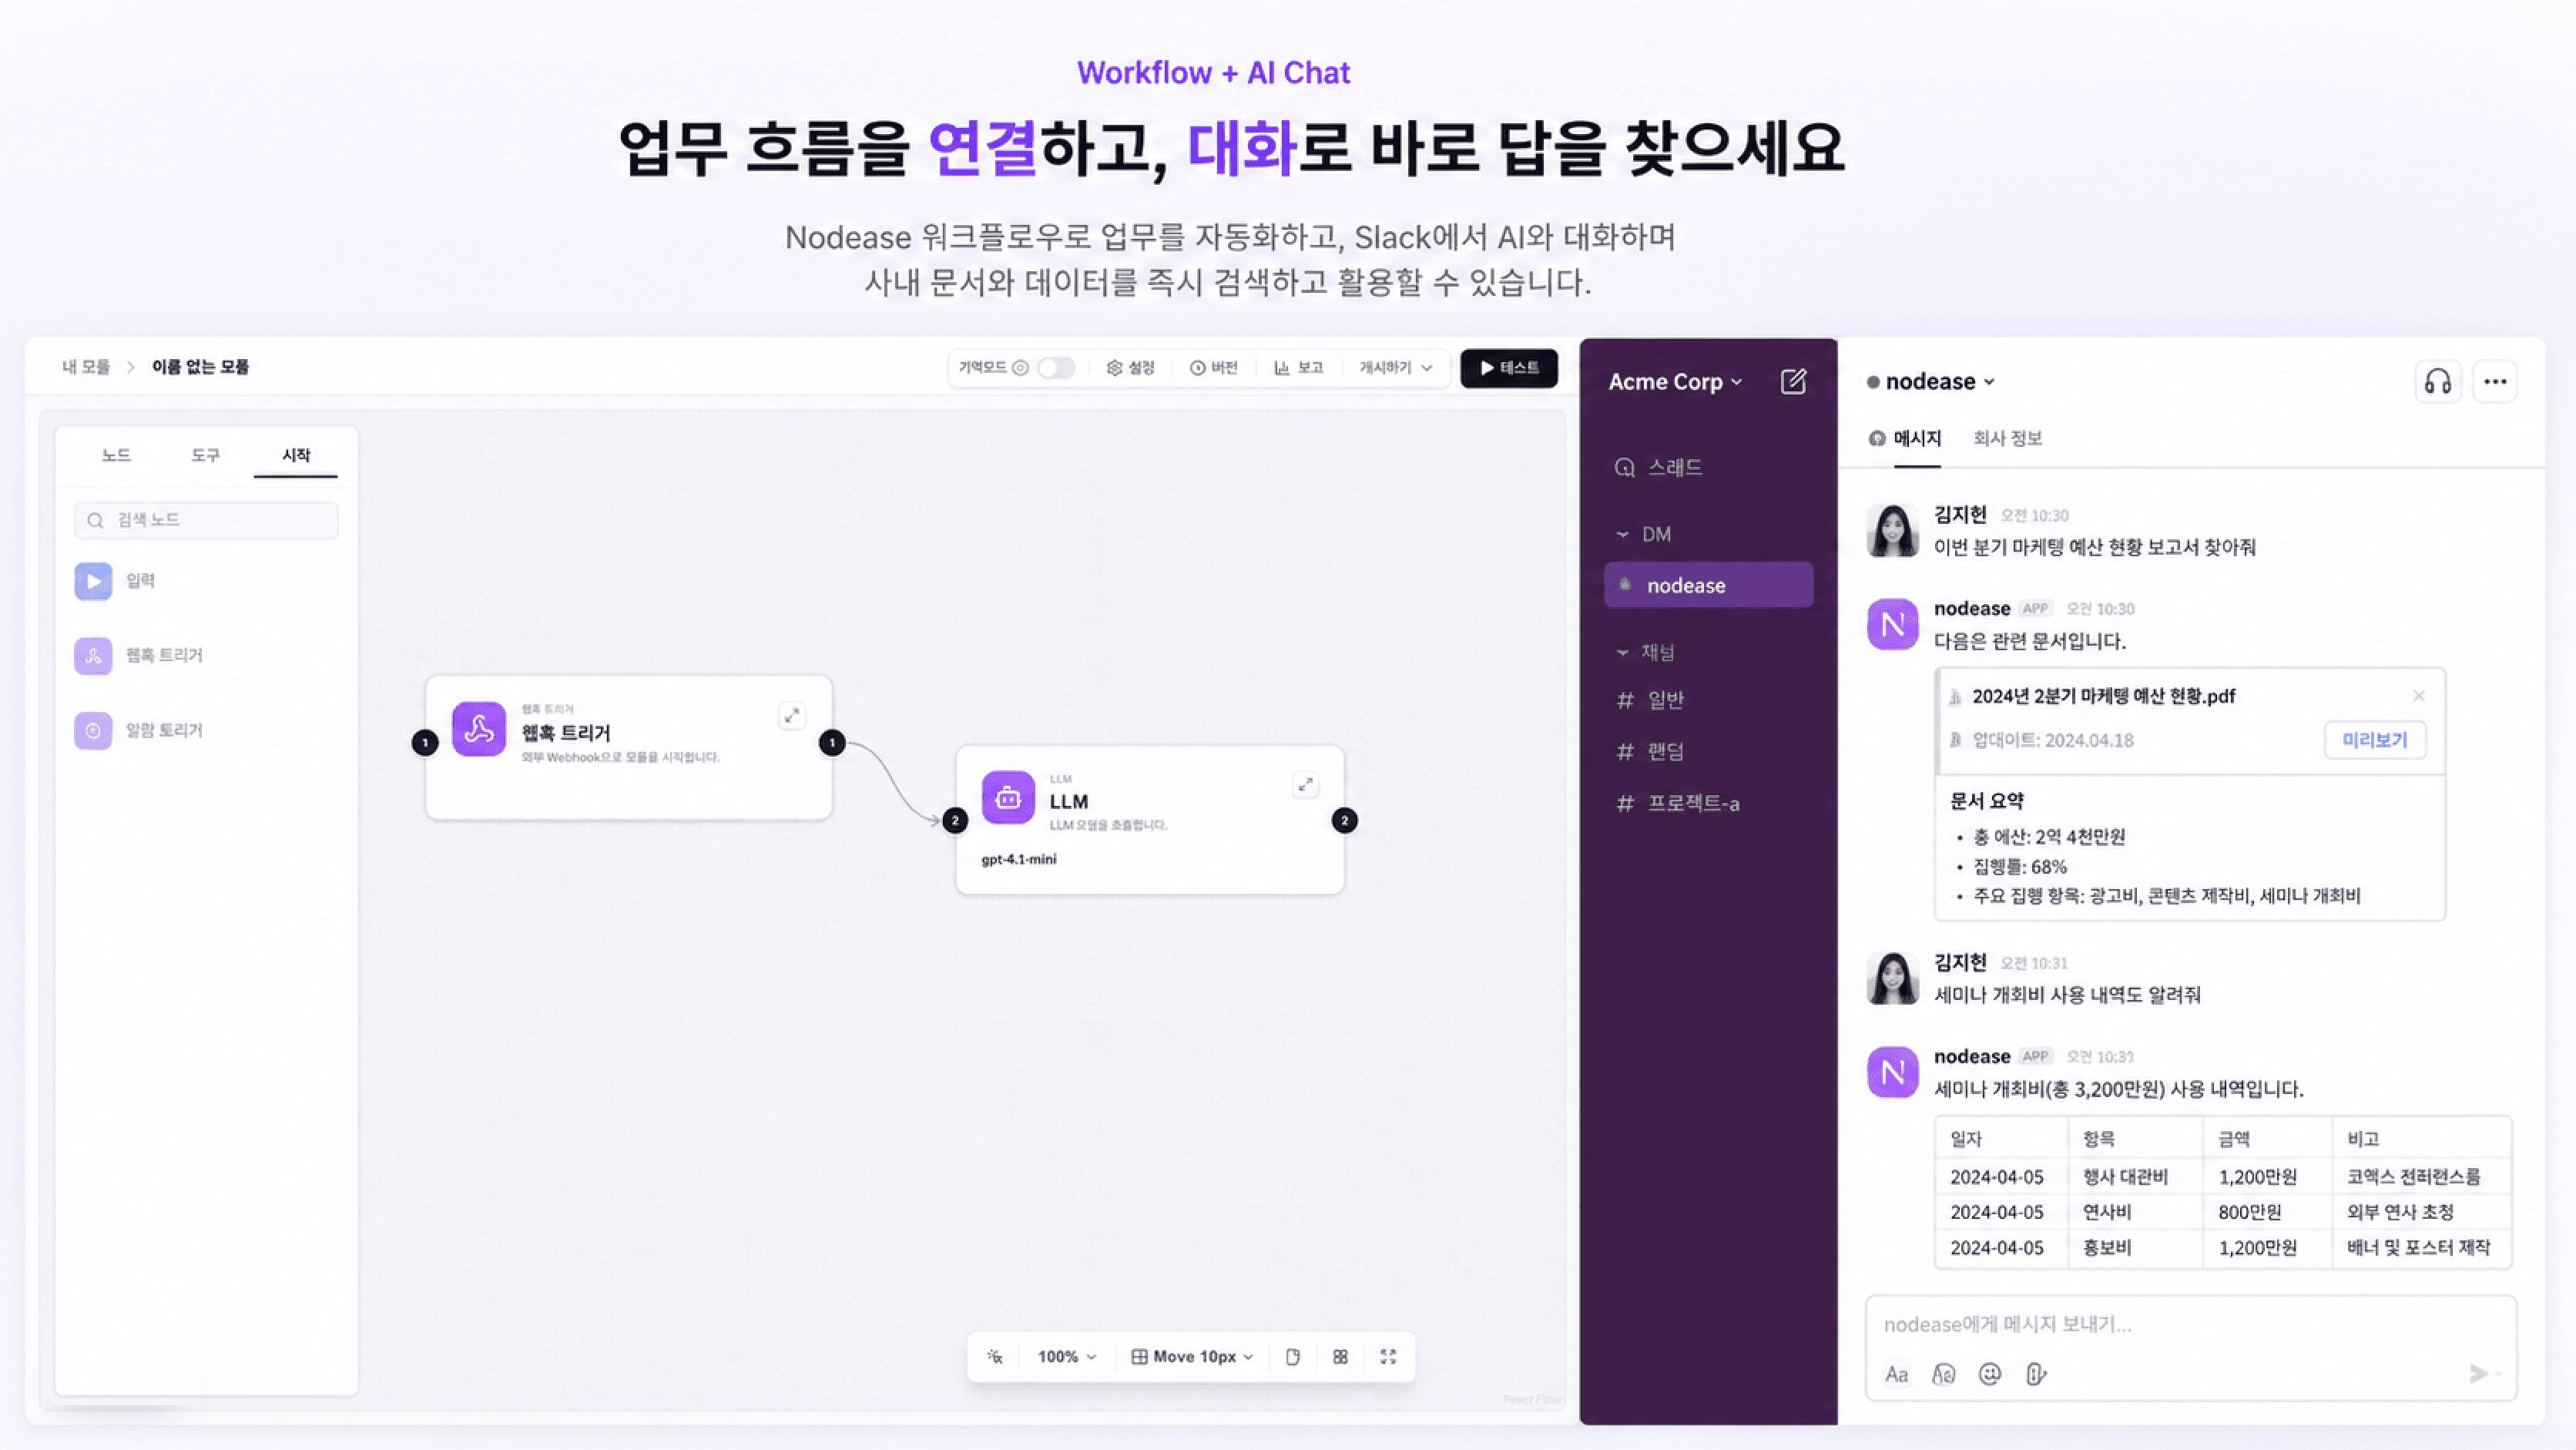
시각적 워크플로우 편집
입력, LLM, RAG, 조건, 외부 도구, 응답 노드를 캔버스에서 연결합니다. 변수 출력을 다음 노드로 드래그하고, 단축키와 복사·붙여넣기, 실행 결과 비교를 이용해 복잡한 흐름을 구성할 수 있습니다.
 PROJECT / NODEASE
기업 내부 사용자가 AI 업무 흐름을 노드로 설계하고 테스트·배포하며, 조직의 권한과 지식 문서, 실행 비용과 감사 기록까지 한곳에서 운영하는 오픈소스 플랫폼입니다.
저는 시각적 워크플로우를 실제로 편집하고 실행하는 경험을 중심으로 개발했고, LLM 노드의 후보 설정을 비교해 비용을 줄이는 Cost Optimizer와 요청 난이도에 맞는 모델을 고르는 자동 라우팅 기능을 프론트엔드부터 실행 엔진, 실험 도구까지 연결했습니다.
사용자가 실제로 경험하는 핵심 기능입니다.
입력, LLM, RAG, 조건, 외부 도구, 응답 노드를 캔버스에서 연결합니다. 변수 출력을 다음 노드로 드래그하고, 단축키와 복사·붙여넣기, 실행 결과 비교를 이용해 복잡한 흐름을 구성할 수 있습니다.
업무 설명을 자연어로 입력하면 필요한 노드와 연결을 제안합니다. 사용자는 생성된 흐름과 필수 설정을 확인한 뒤 워크플로우 편집기에 적용할 수 있습니다.
조직과 팀, 사용자 권한을 기준으로 접근 가능한 Knowledge Base만 검색 후보에 포함합니다. 검색에 사용한 문서와 citation을 실행 기록에 남깁니다.
노드별 토큰, 비용, 지연 시간과 실행 결과를 비교하고 더 적절한 모델 설정을 추천합니다. 자동 라우팅은 요청의 요구 수준과 운영에서 학습한 결과를 바탕으로 후보 모델을 선택합니다.
워크플로우 실행과 노드별 결과, 권한 변경과 주요 작업을 Trace와 Audit Log로 연결합니다. 일반 조회에서는 민감한 입력과 출력이 노출되지 않도록 가시성과 마스킹 정책을 적용합니다.
기능을 만들기 위해 직접 설계하고 구현한 기술 영역입니다.
React Flow 캔버스에 grid snap, 노드 번호, 복사·붙여넣기·복제, undo·redo와 상세 패널 크기 조절을 구현했습니다. 이전 노드의 출력 변수를 칩으로 보여주고 클릭 또는 드래그로 다음 노드 설정에 삽입하도록 만들었습니다.
노드 연결과 필수 입력, 응답 필드 이름을 실행 전에 검사하고 오류 위치를 사용자에게 안내합니다. 테스트 실행 결과와 각 노드 로그, 최종 응답, 이전 실행 비교를 사이드 패널에서 확인하고 다시 열어도 결과를 복원할 수 있게 했습니다.
기준 LLM 노드와 후보 모델·파라미터를 같은 입력으로 실행해 비용, 지연 시간, 출력 계약과 품질을 비교합니다. 추천 설정을 바로 적용하지 않고 미리보기와 재검증을 거치며, 권한과 비용 상한을 통과한 결과만 워크플로우에 반영하도록 구성했습니다.
요청의 난이도와 필요한 능력을 Judge가 판정해 모델을 고르고, 확정된 운영 결과를 로컬 분류기의 학습 데이터로 축적했습니다. 충분히 학습된 경우 로컬 분류기가 먼저 선택하고 자신이 없으면 다시 Judge로 보내는 경로를 구현했습니다.
Next.js 클라이언트와 FastAPI Gateway가 사용자 요청을 받고, Celery 기반 Workflow Engine이 노드를 실행합니다. 공통 권한·데이터·LLM·RAG 계층을 여러 서비스가 공유하며 PostgreSQL과 Redis가 영속 상태와 작업 큐를 담당합니다.
응답 노드에서 한글, 대문자, 공백, 중복 이름처럼 JSON 필드로 안전하지 않은 값을 입력해도 편집 화면에서는 저장할 수 있어 실행 단계에서 오류가 발생했습니다.
프론트 입력 규칙과 Workflow Engine의 데이터 규칙이 분리되어 있었고, 사용자에게 허용 형식과 길이를 안내하지 않았습니다.
영문 소문자로 시작하고 소문자·숫자·언더바만 허용하는 규칙과 최대 32자 제한을 프론트와 Pydantic 스키마에 동일하게 적용했습니다. 중복 이름도 입력 즉시 검사해 오류 이유를 필드 아래에 표시했습니다.
잘못된 응답 구조가 실행 엔진에 전달되기 전에 편집 화면에서 바로 수정할 수 있고, 클라이언트와 서버가 같은 계약을 사용하게 됐습니다.
Judge가 확신하지 못한 요청에서 사용자가 지정한 기본 대체 모델을 그대로 선택하면 보안 검토처럼 높은 추론 수준이 필요한 작업도 저가 모델로 처리될 수 있었습니다.
대체 모델 선택이 현재 요청의 필수 능력과 후보 모델 프로필을 다시 확인하지 않고 설정 순서만 따랐습니다.
요청의 요구 수준, 후보 모델의 능력 프로필과 구조적 조건을 다시 검사해 조건을 만족하는 안전한 모델을 우선 선택했습니다. 첫 번째 모델과 겹치지 않는 두 번째 대체 모델도 같은 방식으로 결정하고 회귀 테스트를 추가했습니다.
저확신 상황에서도 높은 요구 수준의 요청은 `gpt-5.4`, 다음 대체 모델은 `gpt-5-mini`처럼 능력 조건을 충족하는 경로로 닫히게 됐습니다.
화면에서 모델이 자동 선택되는 것만으로는 실제 비용이 줄었는지, 저가 모델 때문에 품질이 떨어지지 않았는지 판단할 수 없었습니다.
모델별 가격과 실행 결과, JSON 계약, 독립 품질 평가를 같은 입력 세트로 비교하는 재현 가능한 실험 도구가 없었습니다.
기업 업무 요청 80건을 자동 라우팅과 고가·중간·저가 고정 모델로 각각 실행하고, 처리 비용·시간·계약 통과 여부를 저장한 뒤 별도 Judge가 모델명을 모르는 상태에서 품질을 평가하도록 구성했습니다.
자동 라우팅은 총 $0.350319로 고가 모델 고정 대비 $1.367401을 절감했습니다. 평균 품질은 85.8점으로 중간 모델 고정보다 0.99점 높고 저가 모델 고정보다 26.55점 높았으며 JSON 계약은 100% 통과했습니다.